

Puntos clave:
- Entrenar a la IA para realizar pruebas de vida requiere una gran cantidad de muestras relevantes y al menos dos conjuntos de datos independientes: uno para el entrenamiento y otro para la validación.
- Un conjunto de datos confiable debe reflejar la diversidad de los usuarios reales en cuanto a origen étnico, género, edad, características físicas, accesorios, dispositivos, condiciones de iluminación y entornos de captura.
- El conjunto de datos debe incluir tanto muestras positivas (imágenes de usuarios legítimos) como negativas (intentos de fraude).
- La principal fuente de errores en las pruebas de vida basadas en IA es un conjunto de datos imperfecto: cantidad insuficiente de muestras, desequilibrios, problemas de aprendizaje incorrecto, etc. Para mejorar el rendimiento, será necesario ajustar (y, en ocasiones, volver a entrenar el modelo con) todo el conjunto de datos.
La incorporación remota de clientes tiene una debilidad evidente: no es posible ver físicamente quién sostiene la cámara.
A veces, hay una persona real al otro lado. Otras veces, se trata de una fotografía impresa, un video reproducido, una máscara, contenido generado por IA o un flujo de video inyectado diseñado para suplantar a una persona.
Esa es la función de la prueba de vida: ayudar a confirmar que la muestra biométrica procede de una persona real físicamente presente durante la verificación.
Sin embargo, como ocurre con muchas otras tecnologías actualmente, la prueba de vida utiliza IA. Esto significa que una prueba de vida confiable basada en IA comienza mucho antes de que el usuario se tome una selfie, con los conjuntos de datos, las etiquetas, las reglas de validación, las muestras de ataques de presentación y los ciclos de reentrenamiento utilizados para enseñar al modelo.
Este artículo analiza ese trabajo entre bastidores: qué se necesita para entrenar a la IA para realizar pruebas de vida, dónde pueden surgir problemas durante el proceso y por qué la calidad de los datos determina si el sistema detecta los intentos de suplantación sin bloquear a los usuarios legítimos.
Para conocer más de cerca los métodos de suplantación que los sistemas de prueba de vida están diseñados para detectar, consulte nuestra guía sobre ataques de presentación en la verificación biométrica→
¿Por qué la prueba de vida necesita IA?
Todas las pruebas de vida modernas utilizan IA de una forma u otra por una razón sencilla: su eficacia.
Los algoritmos de IA procesan grandes cantidades de datos en tiempo real y permiten verificar que los usuarios están vivos sin demoras perceptibles.
Las redes neuronales se entrenan y actualizan continuamente con nuevos datos, por lo que su rendimiento mejora con el tiempo.
Por último, pero no menos importante, la IA puede gestionar muchas pruebas de vida simultáneamente. Esto la convierte en una solución ideal para servicios con grandes bases de usuarios, como la banca en línea, la incorporación remota de clientes y el comercio electrónico.
Sin embargo, esta capacidad tiene un costo.
El modelo necesita más ejemplos de los que imagina
Dado que las redes neuronales aprenden a realizar tareas mediante el análisis de datos existentes, necesitará una gran cantidad de datos relevantes como material de entrenamiento. Estos datos pueden variar según el método: la prueba de vida pasiva requiere imágenes, mientras que la prueba de vida activa requiere videos.
Cuando decimos “una gran cantidad de datos”, lo decimos en serio. Para que su red esté preparada para funcionar en condiciones reales, necesitará no uno, sino dos conjuntos de datos:
-
Un conjunto de datos para el entrenamiento propiamente dicho. Estas muestras deben ser imágenes de la misma naturaleza, calidad y variedad que las que posteriormente enviarán los usuarios reales.
-
Un conjunto de datos para validar los resultados del entrenamiento. Estas muestras son necesarias para comprobar el rendimiento de la red. Es importante no introducir nunca elementos de este conjunto de datos en la red durante el entrenamiento para evitar que el modelo «aprenda las respuestas del examen». En ese caso, la red podría funcionar bien en su entorno de pruebas, pero no lograr generalizar los resultados a nuevos datos en aplicaciones reales.
Por ejemplo, si su conjunto de datos de validación contiene 1,000 muestras, un solo error equivale a una tasa de error del 0.1 %. Para alcanzar una precisión del 99.999 %, necesitará 100,000 ejemplos para demostrar que la red funciona de manera confiable en diversas condiciones.
Pero eso no es todo.
Reciba publicaciones como esta en su bandeja de entrada con el resumen quincenal del blog de Regula
No se puede enseñar a detectar fraudes utilizando únicamente selfies auténticas
El objetivo de una prueba de vida es mitigar el fraude de identidad. Por eso, también necesitará muestras de imágenes fraudulentas, como si alguien estuviera intentando engañar al sistema. Como mencionamos anteriormente, la precisión depende de la cantidad de datos. Por lo tanto, para tener una certeza del 99.9 % de detectar un ataque, la mitad de los elementos de su conjunto de datos deberían representar ataques.
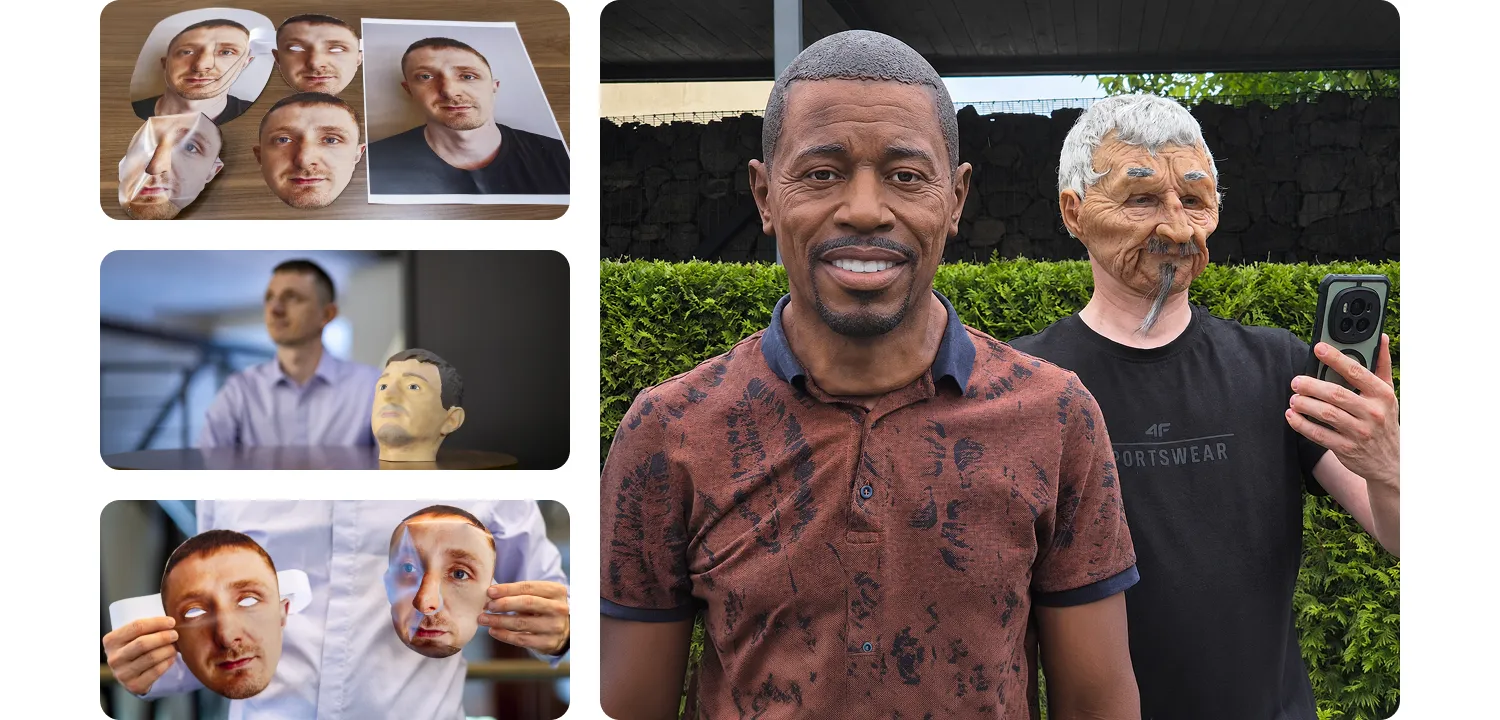
Miembros del equipo de Regula simulando intentos de fraude para entrenar a la IA.
Los usuarios reales no tienen todos el mismo aspecto, ni se mueven o visten de la misma manera
También es importante equilibrar el conjunto de datos para evitar sesgos en el comportamiento de la IA. Si su conjunto de datos se construye principalmente a partir de muestras recopiladas en una sola región, por ejemplo, Europa Occidental, es posible que los usuarios de otras regiones, orígenes étnicos o tonos de piel estén insuficientemente representados. Como resultado, un sistema que de otro modo sería eficaz puede tener un rendimiento deficiente al verificar a personas que no pertenecen al grupo predominante en las muestras de entrenamiento.
Además, las personas suelen utilizar accesorios como lentes, sombreros, bufandas y otros elementos. Estos objetos ocultan partes del rostro, lo que dificulta la tarea, ya que no siempre es posible pedirle a una persona que se quite un accesorio. Los accesorios también pueden utilizarse en ataques fraudulentos para disimular las imperfecciones de las máscaras. Por eso, es importante contar también con este tipo de muestras, para que la red aprenda a gestionar estas características.
Al entrenar el módulo de prueba de vida de Regula, tenemos en cuenta los siguientes atributos:
- Variación demográfica, incluidos el origen étnico, el género y la edad.
- Características físicas: variaciones en el vello facial, el maquillaje, las cicatrices, etc.
- Accesorios: lentes, prendas para cubrir la cabeza y otros accesorios que las personas utilizan habitualmente.
La proporción real de cada atributo depende de su contexto. Lo ideal es que su conjunto de datos se corresponda con la región geográfica en la que opera su empresa. Por lo tanto, si su mercado objetivo incluye países donde es habitual utilizar prendas para cubrir la cabeza por motivos religiosos, necesitará una mayor proporción de este tipo de muestras.

A veces, la IA aprende la lección equivocada
Uno de los riesgos más importantes es que el sistema de IA aprenda patrones incorrectos que den lugar a falsos positivos o falsos negativos.
Estos errores se deben a la forma en que se entrenan las redes neuronales. Cuando se introducen muestras en la red, esta selecciona las características que le permiten proporcionar respuestas correctas. Después, la red recuerda y generaliza estas características para poder aplicarlas al evaluar una nueva muestra desconocida.
El problema es que un conjunto de datos de entrenamiento puede contener patrones engañosos. Sin embargo, un conjunto de datos de entrenamiento también puede contener errores sistemáticos. Por ejemplo, es posible que haya recopilado un gran conjunto de muestras de «ataques» utilizando una cámara con píxeles defectuosos. Estos defectos podrían no ser visibles a simple vista, pero el modelo podría recordarlos como una señal significativa de fraude.
Las muestras enviadas por los usuarios reales no tendrán esta particularidad, por lo que probablemente la red identificará a los defraudadores como usuarios auténticos.
El mismo riesgo aparece cuando el conjunto de datos es demasiado limitado. Si entrena un modelo utilizando únicamente 10 máscaras, probablemente aprenderá a identificar esas máscaras específicas con gran precisión. Sin embargo, cuando un defraudador real utilice una máscara diferente, el modelo podría fallar porque no ha generalizado suficientemente las características.
Corregir estos errores implica ajustar todo el conjunto de datos, ya sea eliminando los datos engañosos, añadiendo nuevos ejemplos o combinando ambas medidas, para ayudar a la red a aprender los patrones correctos.
💡 Por cierto, es peligroso utilizar generadores de imágenes de IA para crear más muestras para sus conjuntos de datos de entrenamiento. Las imágenes sintéticas suelen contener distorsiones, y su modelo puede comenzar a tratarlas como una característica importante.
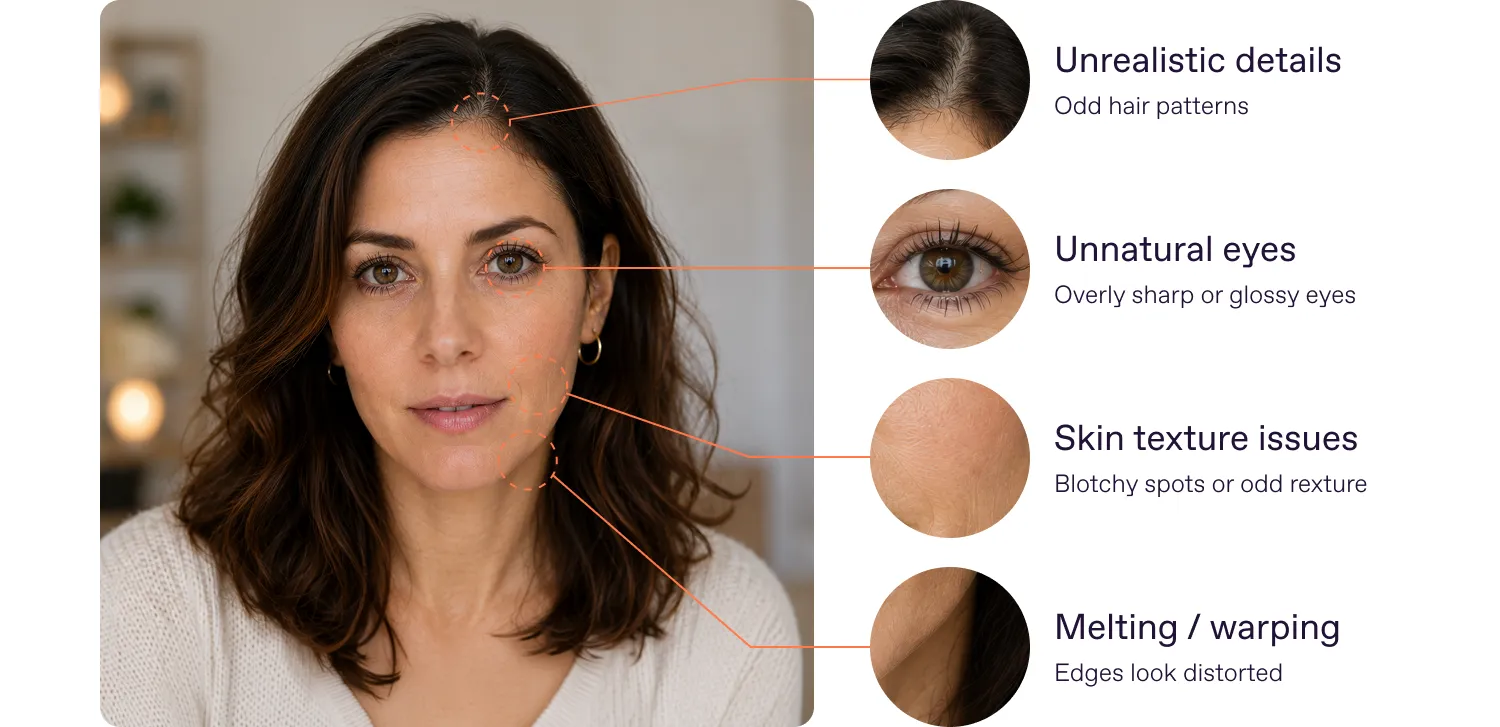
Un resultado incorrecto rara vez tiene una única causa claramente identificable
La red tiene en cuenta numerosos parámetros. Desde el punto de vista técnico, a menudo ni siquiera sabrá exactamente qué ha identificado como un parámetro importante: una textura en la zona de los párpados o una coincidencia de color en determinados puntos de la frente y las mejillas.
Es prácticamente imposible identificar la causa raíz de un error en un ejemplo específico. Por lo tanto, todos los errores se abordan mediante un análisis estadístico amplio, mientras que los casos aislados (entre 3 y 5 ejemplos de errores) aportan poca información y no permiten orientar mejoras sistemáticas.
El criterio humano sigue influyendo en el modelo
Para entrenar un modelo, se necesitan datos etiquetados. En el caso de una prueba de vida, un miembro del equipo etiqueta literalmente cada imagen como “persona real”, “persona no real” o “desconocido”. Lamentablemente, los seres humanos somos propensos a cometer errores.
Los errores en esta etapa son especialmente problemáticos, ya que afectan gravemente al resultado general y son difíciles de detectar. En algunos casos, es posible que el equipo tenga que revisar nuevamente todo el conjunto de datos.
Para minimizar los riesgos, en Regula utilizamos directrices detalladas y capacitamos a los empleados responsables del etiquetado de las muestras para que las decisiones sean coherentes y no dependan de la interpretación de una sola persona.
Además, realizamos una validación cruzada de los datos etiquetados. Dos personas etiquetan de forma independiente las mismas muestras. Si los resultados no coinciden, la muestra pasa a un tercer revisor con más experiencia. Si esta tercera persona no puede tomar una decisión clara, consultamos con expertos en la materia y desarrolladores. Si aun así no es posible tomar una decisión, colocamos estos ejemplos en un grupo separado.
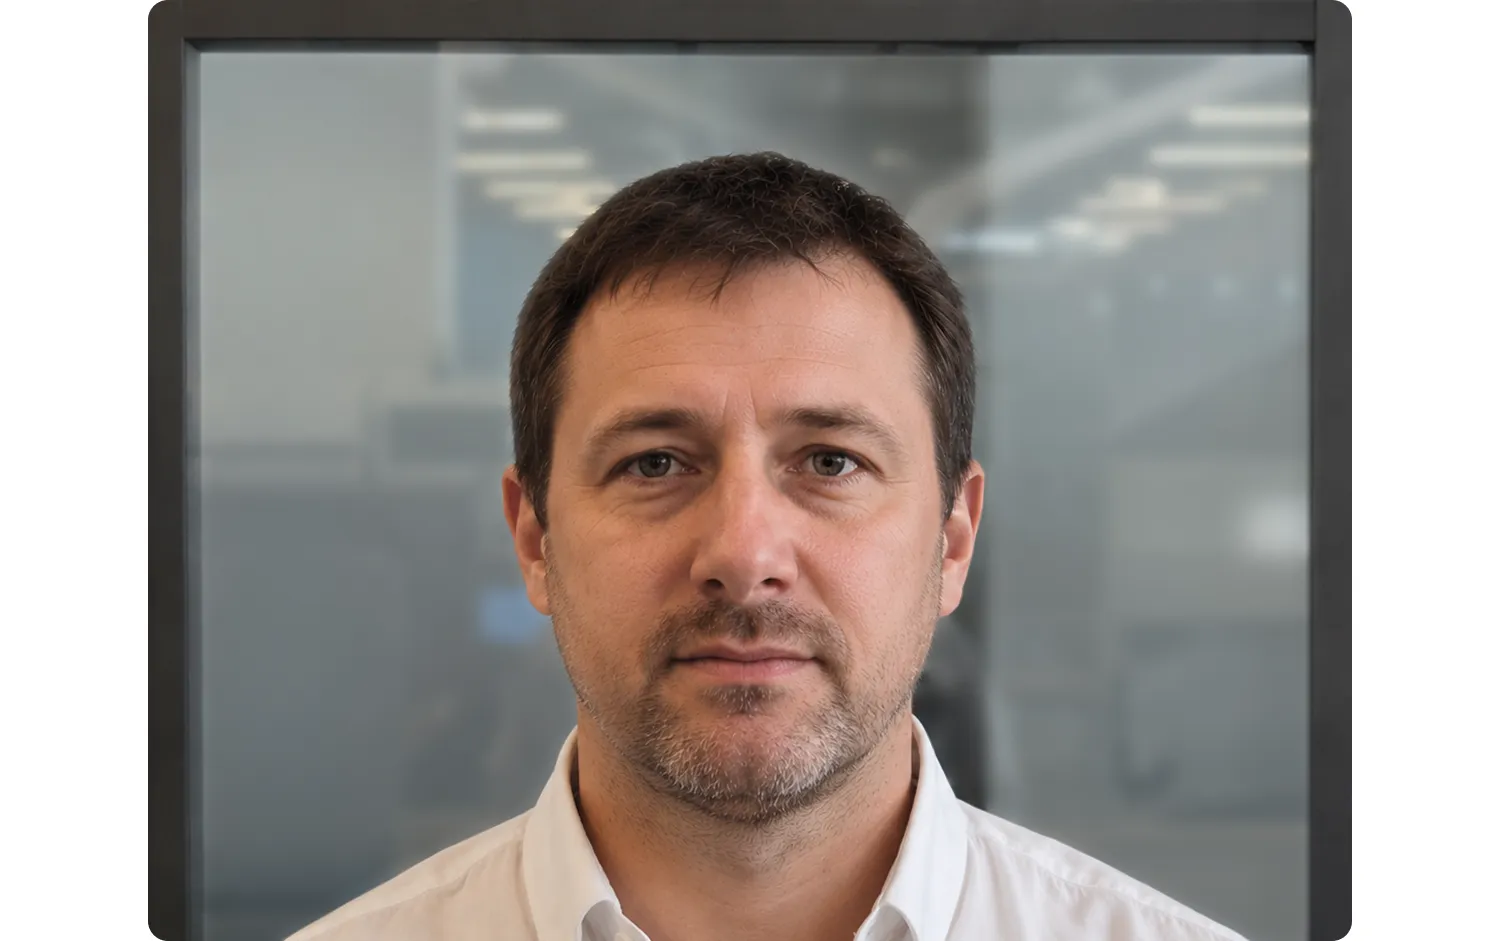
Esta muestra puede ser difícil de etiquetar porque no está claro si la imagen muestra una selfie real o una imagen presentada en una pantalla.
No se puede corregir la IA como si fuera una línea de código
Las redes de IA imitan los procesos humanos de aprendizaje por ensayo y error, por lo que funcionan de una manera más parecida a la de los seres humanos que a la de los algoritmos deterministas tradicionales. Esto implica dos cosas:
-
No son infalibles.
-
Corregir un error en el comportamiento de la IA no es tan sencillo como modificar una línea de código.
Un sistema determinista tradicional sigue una lógica predefinida: si ocurre X, hacer Y. Una red neuronal funciona de manera diferente. Su comportamiento depende de los patrones aprendidos a partir de numerosas muestras, por lo que mejorar el rendimiento en un escenario puede afectar involuntariamente al rendimiento en otro. Por eso, es necesario trabajar sistemáticamente con todo el conjunto de datos: reequilibrarlo, añadir más muestras y corregir los errores.
Una vez más, el tamaño y la calidad del conjunto de datos son importantes. Si solo incluye unas pocas muestras, la red neuronal no funcionará como se espera en aplicaciones reales.
¿Cómo preparar un buen conjunto de datos para una prueba de vida?
Un buen conjunto de datos para pruebas de vida nunca está "listo". Debe ampliarse, revisarse y corregirse a medida que cambian los usuarios, los dispositivos, las condiciones de captura y las técnicas de fraude.
En la práctica, esto se reduce a tres pasos:
| Paso | Por qué es importante |
|---|---|
| 1. Amplíe y actualice su conjunto de datos | Añadir continuamente nuevas muestras a sus conjuntos de datos ayuda al modelo a adaptarse a una amplia variedad de escenarios relevantes y mejora su confiabilidad. Un conjunto de datos limitado genera evaluaciones limitadas. |
| 2. Revise el conjunto de datos | Cada conjunto de datos debe revisarse para detectar imágenes etiquetadas incorrectamente o grupos insuficientemente representados, y debe contener datos lo más precisos e inclusivos posible. Estos desequilibrios en los datos pueden convertirse posteriormente en un problema importante para el modelo. |
| 3. Automatice lo que pueda comprobarse de forma segura | La automatización puede acelerar algunas partes de la revisión del conjunto de datos, como la detección de duplicados o el análisis de la distribución entre grupos demográficos. |
Al entrenar nuestras redes en Regula, aplicamos principios de autoaprendizaje. El proceso se desarrolla de manera iterativa. Una red entrenada etiqueta los datos, que posteriormente son revisados por una persona. Esta persona confirma los resultados o los corrige. Estas correcciones son valiosas porque ponen de manifiesto las imperfecciones de la red. Una vez que se acumula una cantidad suficiente de correcciones, comienza un nuevo ciclo de entrenamiento y etiquetado automático, y el proceso continúa de forma cíclica.
La idea es sencilla, pero su ejecución no lo es.


